Introduction : Sortir du piège de la comparaison technique
Dernièrement, je constate une récurrence troublante : les débats Databricks vs Snowflake tournent systématiquement autour de la performance brute, de la scalabilité ou du coût à la requête. Rarement, en revanche, j'entends poser la question fondamentale : quel outil correspond réellement à la maturité, à la culture et aux besoins métier de mon organisation ?
Lors d'un récent Lunch & Learn que nous avons organisé en interne, nous avons synthétisé nos retours d'expérience sur ces deux écosystèmes, pesant chacun plus de 50 milliards de dollars. Ce qui m'a frappé, c'est à quel point ces deux plateformes incarnent deux visions radicalement différentes du patrimoine informationnel. Databricks porte l'héritage de l'ingénierie data et de l'open source, là où Snowflake défend une promesse d'excellence opérationnelle et d'abstraction totale.
Mon objectif dans cet article n'est pas de décréter un vainqueur. Il est de vous aider à dépasser l'antagonisme technique pour identifier l'adéquation structurelle ce que j'appelle le "fit" entre votre organisation et la plateforme que vous allez adopter pour les cinq prochaines années.
Problématique : L'illusion du choix universel
Le marché de la Modern Data Stack nous a habitués à une promesse séduisante : des plateformes "tout-en-un", capables de répondre à tous les besoins, de l'ingestion de données brutes jusqu'à la visualisation finale. Mais cette promesse d'universalité masque une réalité plus complexe.
Chez un client du secteur bancaire que nous accompagnons depuis deux ans, nous avons observé un échec retentissant : une direction IT avait choisi Databricks pour ses capacités machine learning avancées, sans anticiper que 80 % des besoins quotidiens relevaient de la simple analytique SQL et de la consommation BI via Tableau. Résultat : des équipes métier perdues dans une interface pensée pour des data engineers, et une adoption catastrophique.
Inversement, chez un acteur industriel en pleine montée en compétence IA, Snowflake a montré ses limites dès lors qu'il s'est agi de traiter des volumes massifs de données non structurées et d'entraîner des modèles de machine learning distribués. L'équipe a dû multiplier les outils tiers, créant une dette technique considérable.
Analyse : Deux philosophies, deux ADN
Databricks : La primauté de l'ingénierie et de l'ouverture
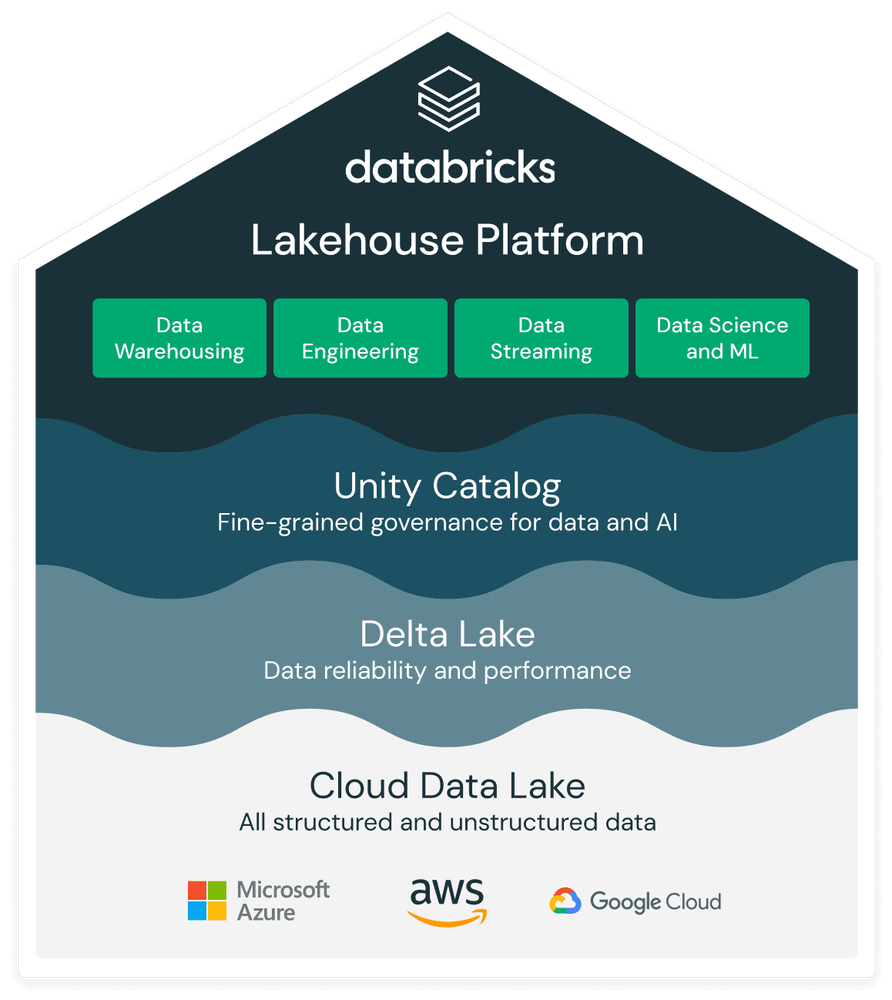
Databricks est né de l'université de Berkeley, fruit direct du projet Apache Spark. Sa genèse repose sur un concept fondateur : le Lakehouse. L'idée est d'unifier l'agilité du Data Lake (capacité à stocker des données brutes, hétérogènes, à moindre coût) avec la rigueur sémantique du Data Warehouse (structure, gouvernance, performance des requêtes SQL).
Concrètement, Databricks vous donne un contrôle total sur votre architecture. Votre stockage reste chez vous : sur AWS S3, Azure Data Lake Storage (ADLS), ou Google Cloud Storage. Le format Delta Lake, open source, garantit une interopérabilité complète et prévient l'enfermement propriétaire (vendor lock-in). C'est une plateforme pensée pour les organisations qui privilégient la souveraineté technologique et disposent d'équipes data engineering matures.
Databricks excelle dans trois domaines :
Data Engineering complexe : traitement distribué de volumes massifs, pipelines ETL/ELT sophistiqués, orchestration fine avec Apache Airflow ou dbt.
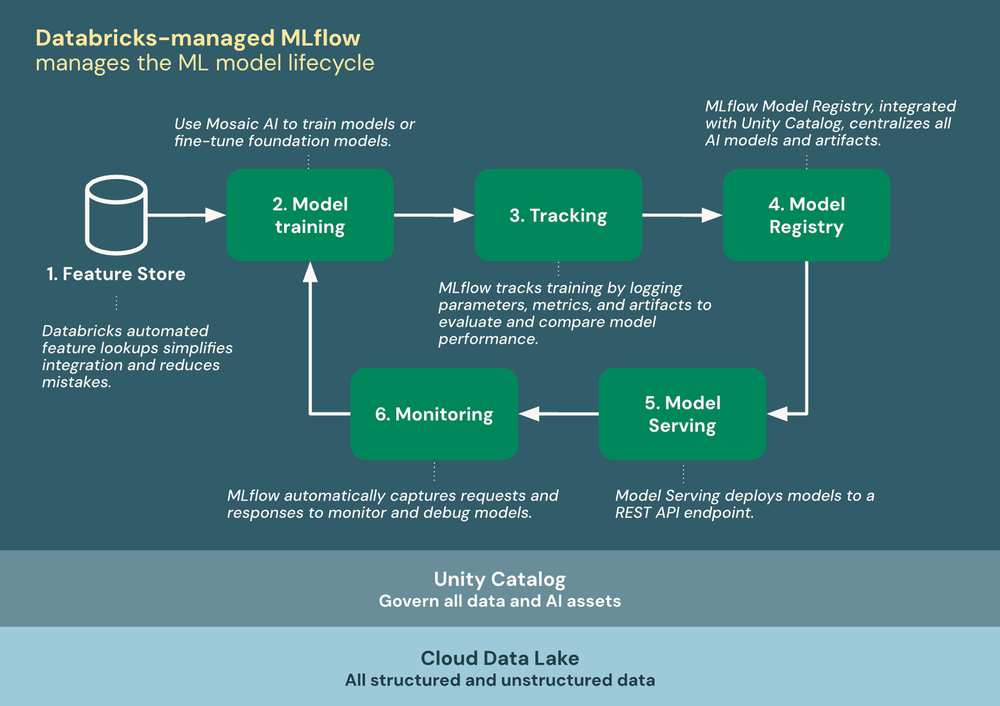
Machine Learning et IA : notebooks collaboratifs, gestion du cycle de vie MLOps avec MLflow, entraînement distribué de modèles, intégration native avec les frameworks Python (TensorFlow, PyTorch, scikit-learn).
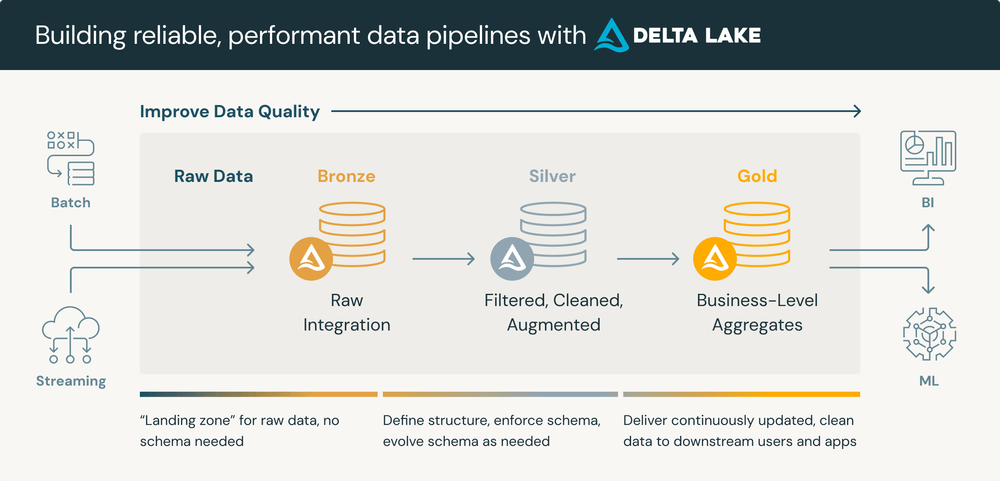
Streaming et données temps réel : Delta Live Tables permet de gérer des pipelines de données en continu avec une latence minimale.
Snowflake : L'excellence opérationnelle et l'abstraction totale
Snowflake a été conçu dès l'origine comme une plateforme nativement Cloud. Son innovation de rupture fut la dissociation stricte des ressources de calcul (Virtual Warehouses) et de stockage. Cette architecture permet d'éliminer les contraintes traditionnelles des bases de données : plus besoin de gérer l'indexation, le partitionnement, ou les tâches d'optimisation bas niveau.
Snowflake privilégie une couche d'abstraction totale. L'utilisateur est affranchi de la complexité d'administration et délègue l'optimisation à l'éditeur. C'est le choix de l'agilité immédiate, au prix d'une dépendance accrue à l'écosystème Snowflake.
Snowflake excelle dans trois domaines :
SQL Analytics et Business Intelligence : performances exceptionnelles sur les requêtes SQL complexes, intégration native avec Tableau, Power BI, Looker, ou Qlik. L'expérience utilisateur est fluide, accessible aux profils non techniques.
Gouvernance et sécurité : gestion fine des accès (RBAC), audit trail complet, chiffrement de bout en bout, conformité RGPD et réglementations sectorielles.
Data Sharing et collaboration : capacité unique à partager des données entre organisations sans duplication ni mouvement de données (Snowflake Marketplace, Secure Data Sharing).
Convergence et guerre des fonctionnalités
Depuis 2022, les deux plateformes convergent rapidement. Snowflake a lancé Snowpark (exécution de code Python et Scala), Snowflake ML (modèles de machine learning intégrés), et Streamlit (visualisation interactive). Databricks a introduit Databricks SQL (interface BI simplifiée), Unity Catalog (gouvernance centralisée), et des performances SQL spectaculaires grâce à Photon Engine.
Cette convergence technologique ne signifie pas pour autant que les plateformes deviennent interchangeables. L'État d'esprit» fondateur de chaque outil demeure. Databricks reste une plateforme pour ingénieurs : puissante, flexible, exigeante. Snowflake reste une plateforme pour analystes et décideurs : immédiate, sécurisée, optimisée pour la consommation SQL.
Recommandations : Trouver l'adéquation structurelle
Quand choisir Databricks ?
Databricks s'impose comme évidence dans certains contextes :
Votre organisation développe des produits data-driven nécessitant du machine learning avancé, des modèles de recommandation, de la détection d'anomalies, ou de l'IA générative.
Vos pipelines ETL/ELT manipulent des données hétérogènes, non structurées (logs, images, JSON complexe, vidéos), ou à haute fréquence (streaming temps réel).
Vous possédez une équipe d'ingénieurs data compétents en Python/Scala, capables de concevoir et maintenir une architecture distribuée.
Vous refusez l'enfermement propriétaire et privilégiez les standards ouverts (Delta Lake, Parquet, Apache Spark).
Exemple concret : chez un client industriel spécialisé en maintenance prédictive, Databricks s'est avéré indispensable pour traiter des capteurs IoT générant 2 To de données par jour, entraîner des modèles LSTM sur GPU, et déployer des prédictions en streaming temps réel via Delta Live Tables.
Quand choisir Snowflake ?
Snowflake s'impose dans d'autres scénarios :
Votre priorité absolue est la consommation BI et l'analytique SQL. 80 % de vos cas d'usage concernent la création de dashboards Tableau/Power BI, de rapports métier, et d'analyses ad hoc.
Vous manquez de ressources d'ingénierie data ou cherchez à réduire votre dette technique. Vous préférez déléguer l'optimisation et la maintenance à un éditeur.
Vous devez partager des données avec des partenaires externes ou acheter des données tierces sur un marketplace (Snowflake Marketplace).
Vos exigences de gouvernance et de sécurité sont critiques (banque, assurance, santé) et vous souhaitez une plateforme certifiée immédiatement.
Exemple concret : un acteur du retail avec lequel nous travaillons utilise Snowflake pour centraliser les données de ses 300 magasins, créer des vues métier self-service pour 200 analystes, et partager des KPIs consolidés avec 12 fournisseurs via Secure Data Sharing. Le tout sans équipe data engineering dédiée.
Mise en œuvre : Une grille de décision pragmatique
Pour structurer votre décision, voici une grille que nous utilisons systématiquement avec nos clients :
1. Diagnostiquer la maturité de votre équipe data
Équipe majoritairement data analyst/BI : privilégiez Snowflake.
Équipe data engineer avancée avec culture Python/Scala : privilégiez Databricks.
Équipe mixte : envisagez une approche hybride (Databricks pour l'ingénierie + Snowflake pour la consommation BI).
2. Cartographier vos cas d'usage prioritaires
Classez vos besoins selon leur importanceù :
Machine learning & IA avancée : Databricks.
Analytique SQL & BI : Snowflake.
Données non structurées (logs, images, JSON) : Databricks.
Partage de données inter-organisations : Snowflake.
3. Évaluer votre posture vis-à-vis du vendor lock-in
Si la souveraineté technologique est un impératif stratégique : Databricks (format ouvert Delta Lake, interopérabilité maximale).
Si la simplicité opérationnelle prime sur l'indépendance : Snowflake (abstraction totale, zéro gestion d'infrastructure).
4. Considérer l'approche hybride
Chez certains de nos clients les plus avancés, nous avons mis en place une architecture duale :
Databricks pour l'ingénierie amont (ETL complexe, ML, données brutes).
Snowflake pour la consommation aval (vues métier, dashboards Tableau, accès self-service).
Cette approche maximise le "fit" de chaque outil, mais introduit une complexité supplémentaire : synchronisation, coûts doublés, gouvernance répartie. À réserver aux organisations matures disposant d'équipes data considérables (> 20 personnes).
Conclusion : Du choix technologique à l'alignement organisationnel
Le débat Databricks vs Snowflake ne se résout pas par une comparaison de features. Il se résout par une introspection honnête de votre organisation : qui sommes-nous ? Quelles sont nos priorités stratégiques ? Quelle culture data voulons-nous incarner ?
Si vous privilégiez l'autonomie technique, la flexibilité architecturale et l'innovation machine learning, choisissez Databricks. Si vous privilégiez la simplicité d'utilisation, l'excellence opérationnelle et l'analytique SQL performante, choisissez Snowflake. Et si vous avez les moyens d'une approche hybride, exploitez le meilleur des deux mondes.
Mais surtout, ne choisissez jamais en fonction de ce qui est à la mode, ou de ce que vos concurrents utilisent. Choisissez en fonction de ce que vous êtes, et de ce que vous voulez devenir.
Parce qu'une plateforme data n'est jamais neutre. Elle incarne une vision, une promesse, une manière de penser le patrimoine informationnel. Et c'est cette vision, bien plus que la vitesse d'exécution d'une requête SQL, qui déterminera votre succès dans les cinq prochaines années.
FAQ
Databricks ou Snowflake : quel est le meilleur choix pour une PME ?
Il n'existe pas de réponse universelle. Pour une PME avec des besoins principalement orientés BI et analytics SQL, Snowflake offre une prise en main plus rapide et une abstraction technique bénéfique. Si vos priorités incluent du machine learning ou du traitement de volummétries massives, Databricks sera plus adapté. L'élément décisif reste la composition de vos équipes : profils SQL dominants = Snowflake ; profils Python/Spark = Databricks.
Peut-on utiliser Databricks et Snowflake simultanément ?
Absolument, et c'est désormais la norme dans les grandes organisations. L'architecture type consiste à utiliser Databricks pour l'ingénierie des pipelines et la construction des modèles ML, puis Snowflake comme couche de consommation pour la BI. Le format Delta Lake garantit l'interopérabilité entre les deux plateformes. Attention toutefois à la complexité opérationnelle et aux coûts cumulés.
Quels sont les vrais coûts d'exploitation de Databricks vs Snowflake ?
Les modèles de tarification (DBU pour Databricks, crédits pour Snowflake) rendent la comparaison difficile. Dans notre expérience, les écarts peuvent atteindre 30-50% selon la configuration et la gouvernance mise en place. Le risque principal n'est pas le coût unitaire, mais l'absence de politiques d'auto-scaling et de mise en veille automatique. Prévoyez systématiquement un monitoring temps réel et des quotas par équipe.
Ressources utiles
Documentation officielle Databricks : https://docs.databricks.com/
Documentation officielle Snowflake : https://docs.snowflake.com/